Know AI. See What’s Next.
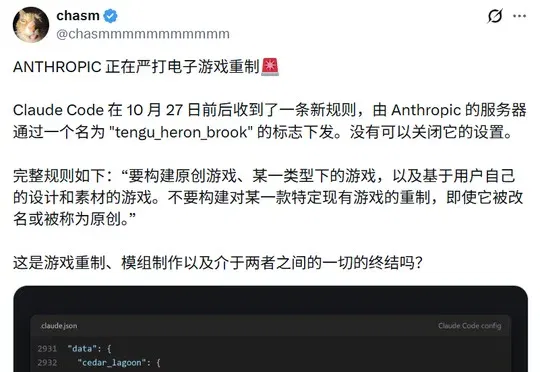
第 1 张,共 5 张:Claude Code 调整游戏生成提示:允许原创,限制复刻特定作品
最新资讯流
Claude Code 调整游戏生成提示:允许原创,限制复刻特定作品(在新窗口打开)
据报道,Anthropic 为 Claude Code 使用 Opus 5.5 时加入提示,允许原创、类型游戏及用户自有设计,限制复刻某款现有游戏。开发者 Addy Osmani 表示团队仍会调整边界并收集误拒反馈;文章进一步讨论 Mod、游戏保存与克隆风险,实际执行仍取决于模型理解。
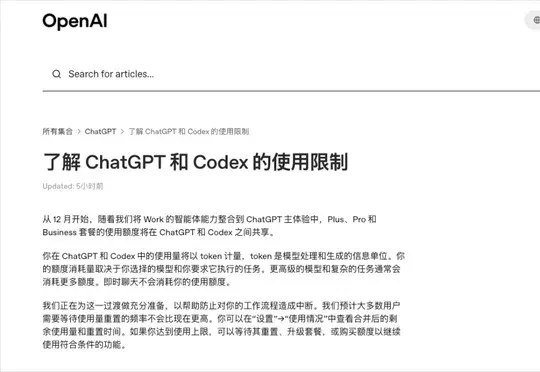
ChatGPT 与 Codex 将共享额度:12月调整及 Instant 聊天例外(在新窗口打开)
OpenAI 帮助文档称,12月起 Plus、Pro 等套餐的 ChatGPT 与 Codex 将共享按 Token 衡量的使用额度,消耗随模型和任务变化,Instant 聊天不计入。作者从重度使用者角度讨论计量带来的顾虑;实际可用任务量尚不能仅凭共享规则推算,也不等同于订阅统一改为逐次付款。
Jev 联合 Treg 开源人员检索工作流,连接候选筛选与邮箱工具(在新窗口打开)
TypeSafe AI 与 Treg 展示面向招聘及商业研究的人员检索流程:Agent 调用数据工具,Jev 判断候选匹配度,再按需查找或验证工作邮箱。文中低价及相对 Clay 的降幅来自平台特定测试,邮箱查找、验证和履历补全分别计费;也有用户反馈检索结果不足。
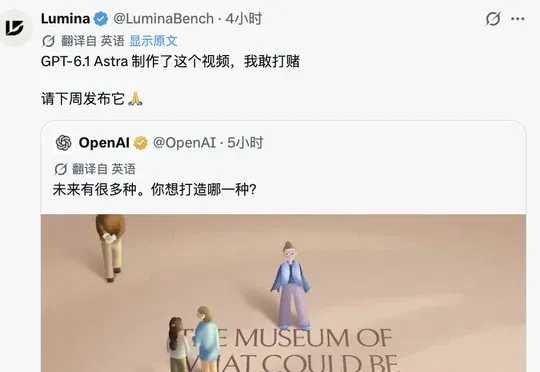
OpenAI 动画引发新模型猜测,12万亿参数仍属未经证实传闻(在新窗口打开)
OpenAI 发布一段动画后,社交平台出现关于 GPT-6.1 Astra 的发布猜测,另有第三方追踪截图被解读为 GPT-6.2 Betelgeuse 线索。文中所引12万亿参数、跑分、价格与上线时间来自匿名或社交平台爆料,尚无相应官方确认,动画本身也不能证明由哪款模型制作。
DeepSeek Super-agent 架构详解:会话路由、异步交互与异常恢复(在新窗口打开)
DeepSeek Harness 团队公开 Super-agent 原型,介绍 Router 与 Worker 双层结构、事件订阅直通、上下文召回,以及计算与执行环境分离。初步合成负载实验展示了多任务耗时与 Token 开销之间的取舍;文章也列出长程记忆、人机接管、安全与隐私等尚待解决的问题。
从 Cowork 到 Cursor:Jenny Wen 的设计经历与 Agent 产品思路(在新窗口打开)
量子位报道,曾参与 Claude 与 Cowork 设计的 Jenny Wen 已转向 Cursor,其社交简介也出现 Grok Bot。文章回顾她从 FigJam 到通用智能体的工作经历,以及对设计流程、快速试错和用户控制的看法;是否能改善新产品体验仍要看后续交付。
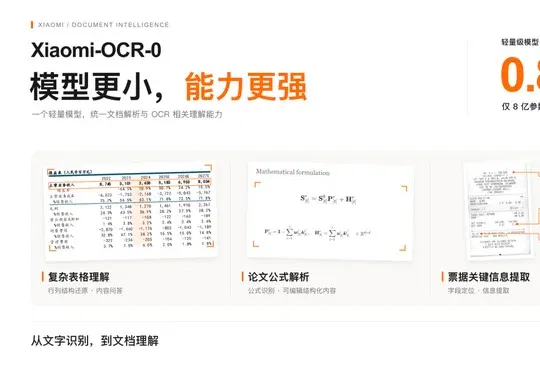
小米开源 Xiaomi-OCR-0,以 0.8B 参数整合文档解析与信息抽取(在新窗口打开)
小米发布并开源0.8B文档理解模型Xiaomi-OCR-0,融合文档解析、关键信息抽取与视觉问答,在OmniDocBench v1.6获96.83分并位列1B以下第一,相关技术正用于小米手机“超级小爱”的识屏办事场景。
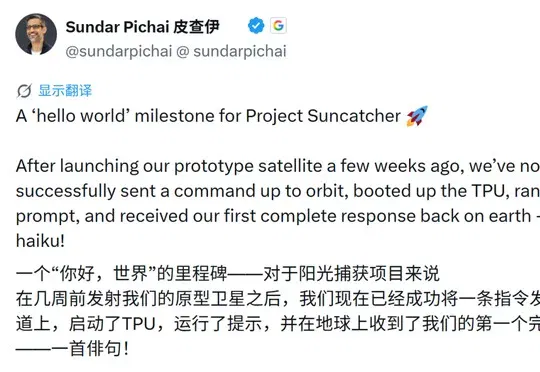
谷歌称 TPU 在轨运行 Gemma 4,原型卫星回传首个 AI 响应(在新窗口打开)
谷歌披露 Project Suncatcher 原型卫星在轨启动 TPU,运行预部署的 Gemma 4 并回传生成结果。文章沿着这次演示梳理太空计算的电力、星间通信、散热与辐射问题:单颗芯片的短时运行已迈出验证一步,规模化集群及经济性仍需要后续实验。
奥特曼谈本地 AI 与云端算力:低利用率内存该如何配置?(在新窗口打开)
在 Cheeky Pint 访谈中,奥特曼从全球 DRAM 供应紧张与利用率出发,认为为低频本地 AI 配置大量闲置内存不如集中于云端,并批评厂商扩产保守。文章也讨论科学研究成本、智能体与计费方式;这番资源配置主张引发了围绕本地计算和个人硬件选择的争论。
报道称字节 Seed 技术负责人周畅离职,创业方向为 Physical AI(在新窗口打开)
Z Finance 报道,字节 Seed 技术负责人周畅已离职,正围绕 Physical AI 创业并获得美元基金支持,融资金额、投资方与产品路线尚未披露。文章回顾其多模态、世界模型与机器人研发经历,也提到此前曾有接近字节人士否认离职消息。
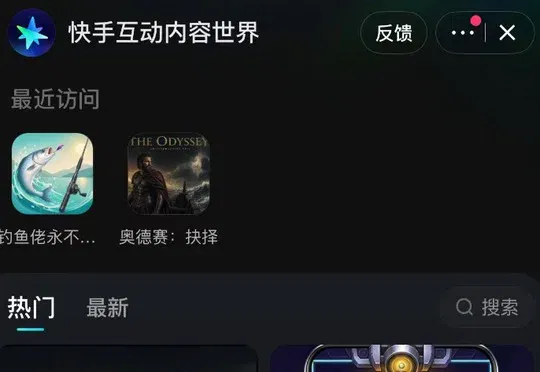
快手上线“互动内容世界”,尝试为轻互动作品提供独立入口(在新窗口打开)
据《读佳》体验,快手的“互动内容世界”以独立入口和作品卡片承载互动叙事、模拟与休闲小游戏,并提供创作者标识和访问记录。文章将其与其他平台的轻互动布局作比较;目前内容池仍小,持续爆款和创作者变现模式尚待验证。
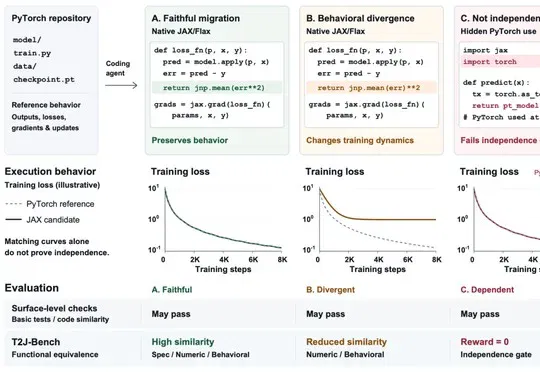
整仓迁移交给Coding Agent,训练与推理行为还能对齐吗?谷歌团队发布T2J-Bench(在新窗口打开)
Google Cloud AI Research等团队发布T2J-Bench,以63个整仓任务评测Coding Agent将PyTorch迁移至JAX的行为保真度,并提出TwinHarness,使Claude-Code与opus-5组合的总体得分从0.649升至0.723,相对提升11.4%。
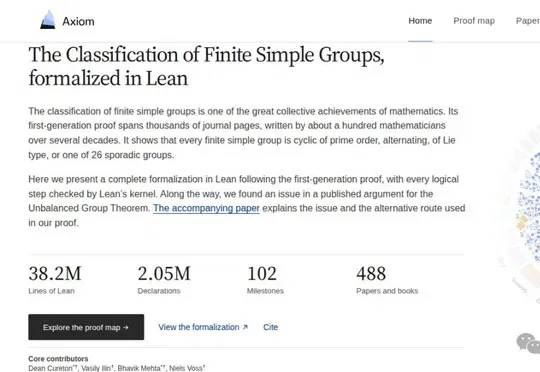
Axiom 宣布完成有限单群分类定理的 Lean 形式化验证(在新窗口打开)
Axiom 宣布在工程师、数学家与多智能体系统协作下,用24天将有限单群分类定理形式化为约4310万行 Lean 代码。团队称过程中修补了已发表论证的多处问题,并借助群论专家意见完成不平衡群定理相关论证,代码与证明说明已开放供检查。
X7 Ultra 如何让大模型用上标称算力?从芯片架构到车企协同(在新窗口打开)
新芯航途介绍 X7 Ultra 的超大核 NPU、专用算子、编译优化与硅前模型验证,尝试减少智驾大模型的数据搬运和计算等待。公司披露的20万颗出货与40余款车型订单属于 X7 系列整体;下一代 X9 和 L4 落地时间仍是后续规划。
把 LibTV 接进 WorkBuddy,聊天式创作走进日常了(在新窗口打开)
作者以短剧、节日营销图和品牌短片体验 WorkBuddy 接入 LibTV 后的聊天式创作:通过连接器组织角色、分镜和素材,再按反馈逐轮返修。案例也暴露了人物遗漏、接口字幕权限与模型参数限制,部分剪辑由本地工具补齐,整合入口并不意味着无需验收。
a16z 投资复盘:AI 资本开支、应用采用与软件市场的分化(在新窗口打开)
a16z 的市场报告与播客从投资者视角讨论 AI 基础设施投入、应用采用和软件市场变化:算力需求推高资本开支,企业同时尝试用 AI 降本与增收。对采用率、估值和未来市场规模的判断取决于统计口径与预测假设,不能把投资人的乐观预期直接视为已经兑现的结果。
DeepSeek,怎么就变成了一条「大肥鱼」(在新窗口打开)
DeepSeek因识图乌龙、网友二创和拟人化传播被塑造成爱摸鱼的“大肥鱼”,与“D老师”粉丝还争夺正统形象,豆包等AI也因官方策略和翻车形成刻板印象。
把模型能力带进真实世界,阶跃星辰与 Builder 们在 ACC 的五天(在新窗口打开)
阶跃星辰与硅星人在ACC 2026开展五天AI创业练习生实践,开发者借助模型、工具和导师支持迭代Demo并完成路演,星空少儿英语、Plain和Aura分获前三名。
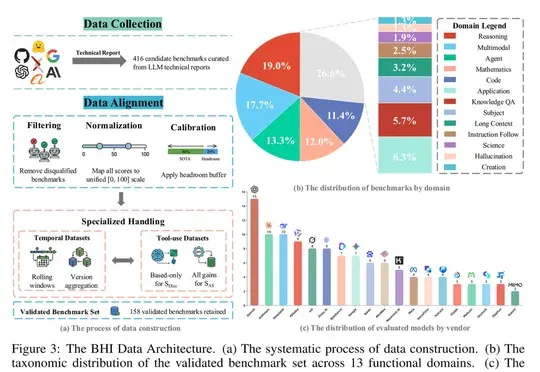
BHI 给158个评测基准做体检:区分度、抗饱和度与采用情况(在新窗口打开)
阿里数据团队提出基准健康指数 BHI,从模型区分度、剩余挑战空间和能力加权采用情况评估 158 个基准,并用留一基准法与扰动实验检查稳定性。它能辅助筛选与复核评测,但不同技术报告的测试条件仍有差异,短期趋势也不能准确预言某套题何时失效。
X7 Ultra 的大模型算力口径:利用率、量化相似度与软硬协同(在新窗口打开)
这篇报道进一步解释新芯航途与 Momenta 如何把量产模型需求带入芯片设计,以及计算图融合、缓存和专用算子如何减少等待。厂商公布的 98.7% 是指定任务下的计算利用率,99.99% 指量化输出与基准的相似度,两者都不能直接当作道路安全率或任意模型的可用算力。